Les demandes d’inscription arrivent toutes en septembre. Elles passent par le formulaire, par mail, parfois en trois lignes sans le nom de l’instrument ni l’âge de l’enfant, et leur tri prend des soirées entières. Un modèle Hermes sur VPS fait ce tri en tâche de fond, sur une machine que vous louez vous-même, avec vos fiches d’élèves qui restent chez vous. L’hébergeur montréalais FFxF a publié un tutoriel détaillé pour installer un modèle Hermes sur VPS avec Ollama, de la taille de la mémoire jusqu’au service qui redémarre seul. À mes yeux, c’est ce qui manquait aux écoles et aux professeurs qui veulent une IA à eux : des chiffres de vitesse mesurés, et pas de promesses.
Un modèle Hermes sur VPS, qu’est-ce que ça change pour une petite structure ?
Hermes 3 est un modèle de langage ouvert, publié par le laboratoire Nous Research. Son rapport technique date d’août 2024 et le modèle existe en plusieurs tailles. FFxF ne le fabrique pas : il l’héberge, sur des machines virtuelles KVM installées à Montréal, sur son propre réseau (AS402554), avec des données qui restent au Canada.
Pour une école de musique, la différence est simple. Vous ne confiez plus les messages des parents à un service grand public. Le modèle tourne sur votre serveur, il lit ce que vous lui donnez, il range, il résume. Et les ressources de la machine sont dédiées. FFxF l’écrit sans détour : « Dedicated resources, never oversold ». Autrement dit, le processeur que vous payez travaille pour vous seul.
Je trouve ce point plus parlant que n’importe quel argument technique. Une association de musique qui gère deux cents dossiers d’élèves sait ce que vaut une machine qui ne ralentit pas parce qu’un voisin de serveur s’emballe.
Quelle taille de machine pour un modèle 8B quantifié ?
Le tutoriel commence par là, et il a raison : on dimensionne avant d’installer. Sa recommandation tient en une ligne. Un modèle 8B quantifié pèse environ 4,7 Go et demande 6 à 8 Go de RAM utilisable. FFxF le qualifie de « sweet spot on a VPS », le point d’équilibre sur un serveur virtuel.
La bibliothèque officielle d’Ollama affiche d’ailleurs le même chiffre pour l’étiquette hermes3:8b : 4,7 Go. Les deux sources se recoupent, ce qui rassure.
Concrètement, le plan Pro de FFxF coche toutes les cases avec ses 4 vCPU et ses 8 Go de RAM. Le plan Scale, avec 16 Go, donne de la marge si vous voulez faire tourner d’autres outils à côté, un Nextcloud pour les partitions par exemple. Mon conseil : partez du Pro. C’est le plan qui correspond pile au repère du tutoriel.
Repères FFxF, relevés le 2 novembre 2026
Quel plan FFxF pour un modèle Hermes 8B ?
Nano
1 vCPU · 2 Go RAM · 20 Go SSD
8,50 CAD/mois
Starter
2 vCPU · 4 Go RAM · 40 Go SSD
16 CAD/mois
Pro · repère du 8B
4 vCPU · 8 Go RAM · 80 Go SSD
30 CAD/mois
Scale
8 vCPU · 16 Go RAM · 160 Go SSD
56 CAD/mois
Modèle 8B quantifié : environ 4,7 Go de poids, 6 à 8 Go de RAM utilisable. Sur 4 vCPU : quelques tokens par seconde, soit 30 secondes à 1 minute par réponse.
Sources : page tarifs et tutoriel Hermes de FFxF ; bibliothèque Ollama (étiquette hermes3:8b).
De l’installation d’Ollama à la commande ollama pull hermes3:8b
Le tutoriel suit un ordre que je recommanderais à n’importe qui. On dimensionne la machine. On installe Ollama, le logiciel qui charge et sert le modèle. On récupère Hermes avec une seule commande, ollama pull hermes3:8b. Puis on règle le démon, c’est-à-dire le service qui tourne en permanence, avec systemd.
Viennent ensuite deux étapes que les guides pressés oublient. L’appel du modèle par son API, d’abord, pour que vos scripts lui envoient les messages à trier. Et surtout l’exposition propre du service, derrière un proxy authentifié. Le tutoriel consacre une section entière à ce point, et c’est pour moi la meilleure : votre assistant ne répond qu’aux personnes autorisées.
Pour qui préfère aller plus vite, FFxF propose aussi une image prête à déployer baptisée « Hermes Agent », parmi les 60 images de son catalogue. La machine est prête en moins de deux minutes. On y trouve aussi Open WebUI, WordPress ou Nextcloud, de quoi loger d’autres outils de l’école au même endroit.
Ce qu’un assistant interne traite bien en tâche de fond
Parlons vitesse, puisque FFxF la mesure. Sur 4 vCPU, un modèle 8B produit quelques tokens par seconde. Comptez 30 secondes à une minute par réponse. Le tutoriel en tire la bonne conclusion : ce type de machine brille dans le traitement en arrière-plan, la classification et l’assistant interne peu sollicité.
Et c’est exactement le profil d’une école de musique. Faites le calcul sur une nuit de septembre. Quarante demandes d’inscription, à une minute chacune au pire, cela fait quarante minutes de travail machine. Le matin, tout est rangé : piano d’un côté, violon de l’autre, éveil musical à part, avec un résumé de deux lignes par famille.
D’autres usages tombent sous le sens. Résumer les messages des parents reçus pendant les vacances. Classer les retours d’un questionnaire de fin d’année. Préparer un brouillon de réponse que le secrétariat relit avant envoi. Rien de tout cela n’exige une réponse instantanée, et tout cela coûte des heures quand on le fait à la main.
Le saviez-vous ?
Hermes 3 n’est pas parti de zéro. D’après son rapport technique publié en août 2024 (arXiv 2408.11857), Nous Research l’a construit en affinant les poids de Llama 3.1 de Meta. Sur la bibliothèque Ollama, la version 8B pèse 4,7 Go, le chiffre exact retenu par le tutoriel de FFxF.
Sources : bibliothèque Ollama, page hermes3, consultée le 2 novembre 2026 ; présentation du rapport technique Hermes 3.
Ressources dédiées, charge soutenue autorisée et données au Canada
Un modèle qui tourne une nuit entière fait travailler le processeur sans pause. Chez certains hébergeurs, la question se pose. Chez FFxF, elle est tranchée par écrit : la charge CPU soutenue est acceptée, et l’inférence de modèles de langage figure noir sur blanc dans la liste des usages admis, aux côtés du calcul et des compilations continues. Le minage de cryptomonnaies, en revanche, fait partie des usages interdits.
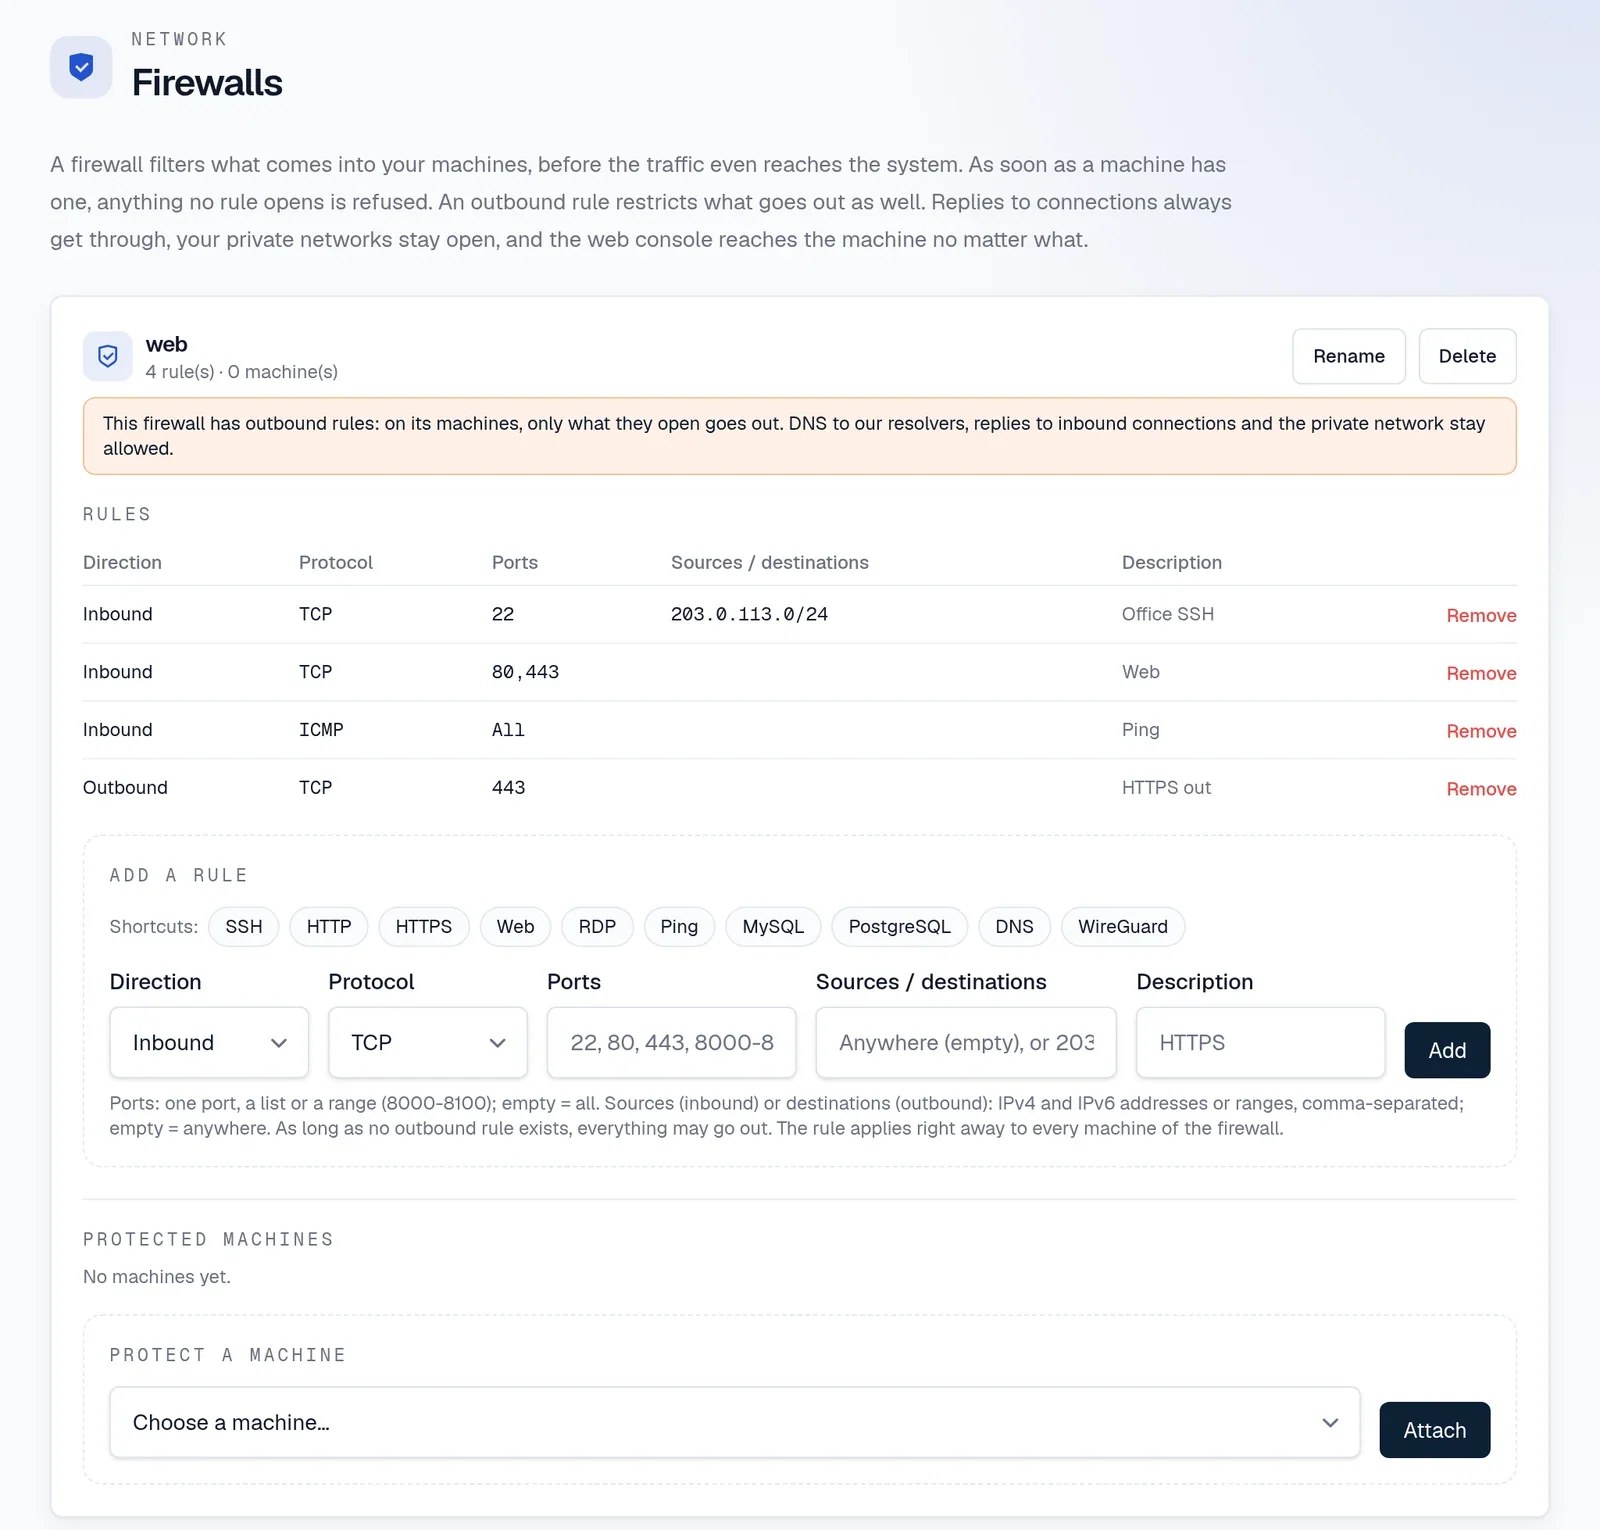
Chaque machine arrive avec une IPv4, un bloc IPv6 /64 routé, 7 sauvegardes manuelles incluses et une console de gestion. Le support est humain, basé à Montréal. Ajoutez les réseaux privés et le pare-feu proposés par l’hébergeur, et votre assistant peut parler à vos autres serveurs sans jamais passer par Internet.
La localisation compte aussi. Vos données restent au Canada, sur un réseau que FFxF exploite lui-même. Son blog consacre d’ailleurs un tutoriel complet à l’hébergement de données au Canada, avec la loi 25 du Québec, la LPRPDE et le CLOUD Act. Pour une structure qui manipule des fiches d’enfants mineurs, je lirais celui-là juste après le tutoriel Hermes.
Les plans FFxF pour un assistant interne, de Nano à Scale
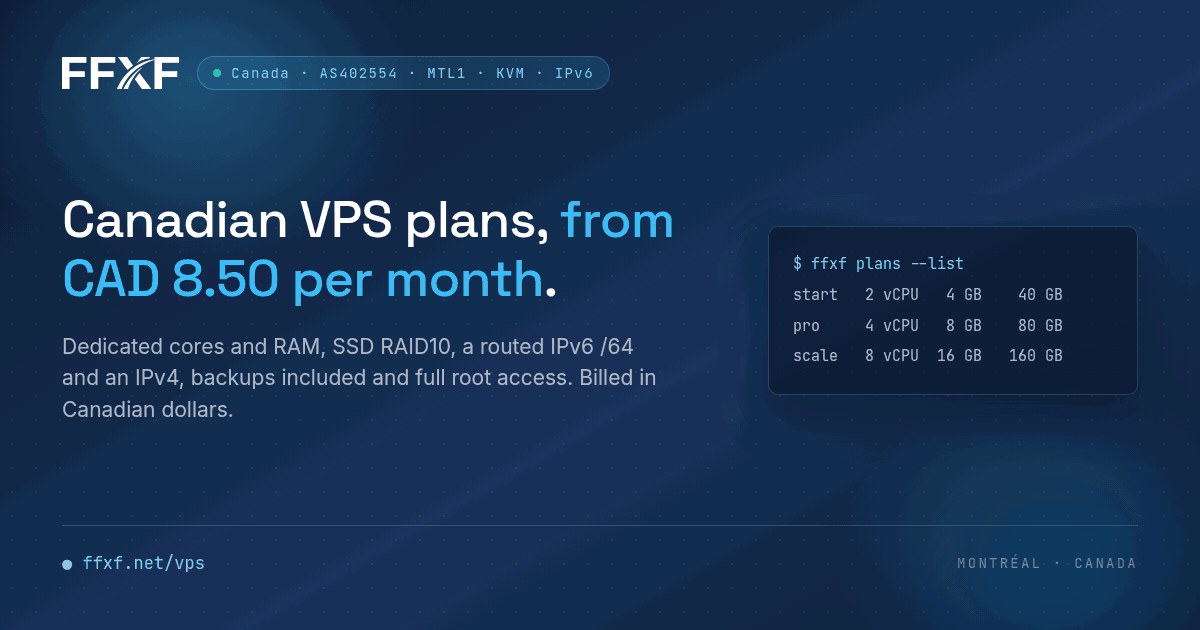
La grille tient en quatre lignes, et tout est affiché. Nano à 8,50 CAD par mois, Starter à 16 CAD, Pro à 30 CAD, Scale à 56 CAD. Les prix sont en dollars canadiens, taxes incluses, sans frais d’installation, avec 1 To de trafic par machine.
Ce qui me plaît le plus, c’est la souplesse. La facturation se fait à l’heure, au mois ou à l’année, à partir de 0,018 CAD de l’heure. Au-delà de 1 To de trafic, rien n’est coupé ni ralenti : le surplus est facturé 2 CAD le To, au prorata. Et si vous vous passez d’IPv4 public, la machine coûte 2 CAD de moins par mois.
Pour se lancer, FFxF offre 5 $ de crédit de départ. Le premier abonnement VPS est remboursé, une fois par client, si vous le demandez depuis la console dans les 7 jours qui suivent le paiement de sa première facture.
Nano et Starter conviennent très bien aux outils légers de l’école, un site WordPress ou un petit service. Pour Hermes 8B, le Pro est le palier qui colle au repère du tutoriel. Mon conseil pour démarrer : louez un Pro à l’heure, lancez une nuit de tri sur les demandes de la rentrée, puis passez au mois quand le rythme vous convient.
Questions fréquentes
Quel plan FFxF choisir pour un modèle Hermes 8B ?
Le plan Pro, avec 4 vCPU, 8 Go de RAM et 80 Go de SSD à 30 CAD par mois. Le tutoriel de FFxF indique qu’un 8B quantifié pèse environ 4,7 Go et demande 6 à 8 Go de RAM utilisable. Le plan Scale, avec 16 Go, donne de la marge pour d’autres outils.
Combien de temps met Hermes 8B pour répondre sur un VPS ?
Sur 4 vCPU, FFxF mesure quelques tokens par seconde, soit 30 secondes à une minute par réponse. C’est le bon rythme pour le traitement de fond : tri de demandes, classement, résumés, assistant interne peu sollicité.
Comment installe-t-on Hermes avec Ollama ?
Une fois Ollama installé sur le VPS, la commande ollama pull hermes3:8b récupère le modèle. Le tutoriel de FFxF détaille ensuite le service systemd, l’utilisation de l’API et l’exposition derrière un proxy authentifié. Une image « Hermes Agent » prête à déployer existe aussi dans son catalogue.
Peut-on payer un VPS FFxF à l’heure ?
Oui. La facturation se fait à l’heure, au mois ou à l’année, à partir de 0,018 CAD de l’heure, en dollars canadiens, taxes incluses et sans frais d’installation.
Sources
FFxF, « Self-hosting a Hermes model on a VPS with Ollama », tutoriel consulté le 2 novembre 2026.
FFxF, pages Tarifs, Machines virtuelles et Réseaux privés, consultées le 2 novembre 2026.
Ollama, bibliothèque de modèles, page hermes3 (étiquette 8b), consultée le 2 novembre 2026.
Nous Research, rapport technique Hermes 3 (arXiv 2408.11857, août 2024), via la présentation de Fast.io.
Rédactrice spécialisée · marketing musical, outils pédagogiques, innovation
Camille Leroux écrit sur l'éveil musical et le choix d'un premier instrument pour MusiProf.